20센트.
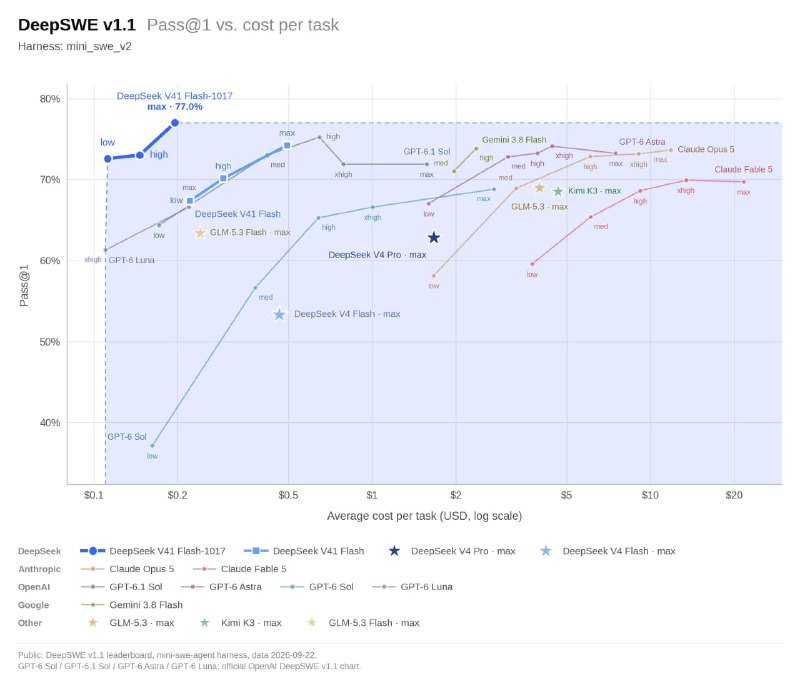
딥시크가 토요일에 내놓은 V4.1 플래시 1017이 소프트웨어 과제 하나를 푸는 데 드는 돈이다. 이 돈으로 과제의 77%를 풀었다. 오픈AI의 어떤 모델을 어떤 설정으로 돌렸을 때보다도 조금 높은 점수다. 같은 과제를 클로드 오퍼스 5의 가장 강한 설정에 맡기면 예순 배 가까운 돈이 들고, 점수는 오히려 낮다. 게다가 딥시크는 이 모델을 누구나 내려받아 쓸 수 있게 공개했다.
그날 밤 많은 전문가들이 다음 주 AI 주식은 폭락 정도로 끝나지 않을 거라고 내다봤다. 과장이 섞인 전망이었지만 나도 비슷한 걸 느꼈다.
그래프 한 장이 섬뜻하다. 왼쪽 위 구석에 딥시크의 파란 점이 혼자 떠 있고, 오픈AI도 앤트로픽도 구글도 그보다 비싸면서 덜 맞히는 자리에 모여 있다.
점수가 비슷한 것끼리 맞춰 보면 값 차이가 더 선명하다. 딥시크가 가장 아끼는 설정으로 12센트에 73% 가까이 맞힐 때, 클로드 오퍼스 5는 비슷한 점수에 50배를 쓴다. 구글과 오픈AI의 비슷한 점수대 모델들도 20배에서 40배를 쓰고, 클로드 페이블 5의 가장 비싼 설정은 100배 넘게 쓰고도 점수가 더 낮다. 오픈AI의 GPT-6.1 솔만 서너 배 차이로 따라붙었지만, 점수는 딥시크의 최고치에 못 미친다.
AI의 가격은 원래 빠르게 떨어져 왔다. 2021년 GPT-3급 모델로 100만 토큰을 쓰려면 60달러가 들었는데, 5년 만에 천분의 일이 됐다. 그래도 싸진 건 대개 초안과 시행착오였다. 마지막에 맞는 답을 내는 일은 여전히 가장 비싼 모델의 몫이었다. 20센트는 그 마지막 칸까지 싸졌다는 신호다.
정답이 싸지면 정답을 비싸게 팔던 곳부터 흔들린다. 미국의 프론티어 랩은 사실 시간을 판다. 경쟁자보다 먼저 도착한 성능에 고객이 웃돈을 낸다. 나는 그 웃돈이 붙어 있는 기간을 '지능의 유통기한'이라고 부르고 싶다.
웃돈의 정체는 미국 모델의 가장 비싼 설정에서 드러난다. 더 오래 생각하라고 돈을 더 냈는데, 점수는 한 단계 아래 설정보다 오히려 낮았다. 그 끝자락에서 고객이 사는 건 점수가 아니다.
유통기한을 줄이는 힘은 앞선 모델 자신에게서도 나온다. 앞선 모델은 공개되는 순간 뒤따르는 모델의 교과서가 된다. 앤트로픽은 지난달 보고서에서 딥시크가 2주 동안 클로드와 천만 번 넘게 대화하며 그 답으로 자기 모델을 학습시키려 했다고 주장했다. 자전거 경주에서 맨 앞 선수는 바람을 혼자 맞고, 바로 뒤에 붙은 선수는 그 바람막이 덕에 힘을 아낀다. 앞서가는 비용은 해마다 수백억 달러씩 커지는데, 따라가는 비용은 계속 줄어든다. 따라잡은 다음에는 고객의 손안으로 들어온다. 딥시크는 클로드 코드와 코덱스 안에서 딥시크 모델로 검색하면 당분간 공짜라고 했다. 미국 회사가 만든 차는 그대로 타고 엔진만 바꿔 끼우라는 제안이다.
딥시크는 자기 모델의 유통기한도 봐주지 않는다. 얼마 전까지 플래그십이던 V4 프로는 이번 모델보다 여덟 배 비싸고 점수는 한참 낮다. 딥시크는 V4 프로를 이미 은퇴시키고 그 요청을 더 작은 모델로 돌렸다. 자기 플래그십을 한 계절 만에 버리는 회사와, 몇 달의 앞섬으로 먹고사는 회사가 같은 시장에 서 있다.
시점도 얄궂다. 오픈AI는 올해 상장을 접었고, 앤트로픽은 10월이던 상장을 11월로 미뤘다. 시장이 미국 AI 회사의 몸값을 처음으로 직접 매기려는 순간에, 같은 일을 비교도 되지 않게 싸게 하는 모델이 나왔다. 앤트로픽이 이번 주 투자자들에게 보여준 매출총이익률 85%는 조정을 거친 숫자다. 같은 자리에서 앤트로픽은 컴퓨팅에 1달러를 쓰면 매출 1.7달러가 나온다고도 했다. 화려한 마진 뒤에 남는 몫은 생각보다 얇다.
그렇다고 미국 랩이 바로 무너지지는 않을 것이다. 싸고 쓸 만한 중국 모델은 올해 내내 있었는데도 앤트로픽의 3분기 매출은 직전 분기보다 절반 가까이 늘었다. 기업은 회사 코드와 고객 데이터를 맡길 때 점수표만 보지 않는다. 사고가 나면 누가 책임지는지를 본다. 그래프는 정답의 값을 보여줄 뿐, 그 정답을 믿어도 되는지, 누가 서명하는지는 보여주지 않는다. 미국 랩이 살아남는 길은 답을 파는 회사에서 서명을 파는 회사로 바뀌는 것이다. 정부 조달 기준과 중국 모델 사용 제한 같은 제도가 그 서명을 지키는 울타리가 될 것이다.
문득 반도체 산업이 걱정된다.
지난달 딥시크는 모델이 대화를 기억하는 데 쓰는 메모리를 이전 모델의 4분의 1로 줄였다고 밝혔고, 다음 날 삼성전자와 SK하이닉스 주가가 함께 빠졌다. 반도체 업계의 반론에는 이름이 있다. 제번스의 역설이다. 영국 경제학자 제번스는 증기기관이 석탄을 아껴 쓰게 되자 오히려 석탄 소비가 폭발했다는 것을 발견했다. 효율이 좋아지면 쓰는 양이 늘어 전체 소비가 커진다. 작년 초 딥시크 R1이 시장을 흔들었을 때 마이크로소프트의 사티아 나델라가 꺼낸 말도 이것이었다.
다만 제번스의 역설이 약속하는 것은 석탄이 더 많이 팔린다는 것까지다. 얼마에, 어느 탄광에서 캔 석탄이 팔릴지는 약속하지 않는다.
먼저 값이다. 석탄은 창고에 쌓아 두어도 내년에 같은 값을 받지만, 지능은 몇 달이면 값이 상한다. 빅테크는 올해 데이터센터에 7천억 달러 넘게 붓고, 그 안의 GPU를 5년에서 6년에 걸쳐 비용으로 나눠 잡는다. 그 GPU로 만든 최신 모델이 비싼 값을 받는 기간은 몇 달뿐이다. 6년짜리 장비로 몇 달이면 상하는 상품을 만드는 셈이다. 정답 하나의 값이 예순 분의 일로 떨어지면, 열 배 더 팔아도 손에 쥐는 돈은 6분의 1이다.
다음은 탄광이다. 딥시크 모델은 엔비디아 칩 없이도 돌아간다. 딥시크는 새 데이터센터에 화웨이 칩 16만 개를 들이기로 했다. 훈련은 당분간 엔비디아에 맡기고, 모델을 돌려 답을 내는 일부터 화웨이로 옮긴다. 돈이 실제로 오가는 쪽부터 옮겨 가는 셈이다. 중국 AI 칩 시장에서 엔비디아와 화웨이의 점유율 차이는 이미 한 자릿수까지 좁혀졌다. 석탄은 더 많이 캐겠지만, 다른 탄광에서 캘 수도 있다.
상상해 보자. 2027년 봄, 새 모델 출시 페이지 아래에 작은 글씨가 붙는다. 이 가격은 90일 동안 유효합니다. 데이터센터 대출 심사장에서 은행원은 칩의 성능보다 그 칩이 팔 정답의 평균 단가를 먼저 묻는다. 기업은 비싼 모델을 중요한 판단 몇 번에만 부르고, 나머지 수천 번의 반복 작업은 사무실 구석 서버의 공개 모델에 맡긴다. 그 서버는 어느새 정수기처럼 층마다 한 대씩 놓인다. 반도체 회사의 실적 발표에는 정답 하나의 값이 얼마나 빨리 떨어지는지 보여주는 그래프가 붙고, 투자자들은 그 기울기로 내년 메모리 주문을 가늠한다.
한국은 이 장면 한가운데 서 있다. 우리는 지능이 비쌌던 시대에 메모리로 가장 큰 덕을 본 나라다. 정답을 생성하는 비용이 이정도 수준으로 빠르게 떨어지면, 계획대로 칩을 많이 파는 것만으로는 그 덕이 오래가지 않는다. 다음 판의 몫은 넘쳐나는 정답을 검증하고 그 결과에 서명하는 쪽에 있을지 모른다.
월요일 서울의 금융시장은 뉴욕보다 반나절 먼저 열린다. 딥시크가 줄인 메모리의 첫 성적표는 서울의 시세판에 먼저 찍힐 것이다.
오늘의 20센트도 머지않아 비싼 값이 된다. 누군가 더 싼 점을 찍는 날, 오늘의 파란 점은 무리 속으로 조용히 밀려날 것이다. 우유갑에 날짜가 찍히듯 이제 지능에도 날짜가 찍힌다.
그런데 날짜가 지나지 않는 질문이 하나 남는다. 이 답을 믿어도 되는가.